
Recuperación de archivos: cómo funciona la recuperación de datos
Tallado de limas localiza y extrae archivos leyendo sus datos en lugar de utilizar los registros del sistema de archivos. Busca patrones de bytes conocidos, comprueba la estructura del archivo e identifica los posibles puntos de inicio y fin. Esto puede resultar útil cuando se han perdido los registros de carpetas o archivos. Sin embargo, es posible que no recupere los nombres de los archivos antiguos ni reconstruya los archivos fragmentados.
El método funciona con datos que una herramienta aún puede leer. Se puede aplicar a unidades NTFS, FAT32 y exFAT, así como a discos duros, memorias USB, tarjetas SD, discos SSD e imágenes de disco.
Índice
Cómo funciona el «file carving»
Un típico recuperación de archivos El escaneo consta de cuatro pasos:
- Buscar datos legibles que coincidan con firmas de archivos conocidas.
- Comprueba cada coincidencia y lee la estructura de su archivo.
- Determina el inicio y el final probables del archivo.
- Copia los datos y comprueba el resultado.
Algunas herramientas analizan el espacio libre. Otras analizan un volumen completo o una imagen de disco. El área de análisis depende de la herramienta y de la tarea.
Buscar encabezados y firmas de archivos
Una firma de archivo es un conjunto de bytes que puede indicar un tipo de archivo. Una herramienta de recuperación busca estos patrones para localizar posibles archivos.
Por ejemplo, un archivo PNG comienza con esta firma de ocho bytes: 89 50 4E 47 0D 0A 1A 0A.
Una coincidencia indica que podría tratarse de un archivo PNG. No prueba que la imagen completa siga estando ahí. Es posible que algunos bytes hayan desaparecido, estén dañados o se hayan mezclado con datos de otros archivos. Recuperación de archivos basada en firmas Comienza con esta búsqueda, aunque los métodos más exhaustivos también comprueban la estructura del archivo.
El nombre o la extensión de un archivo no constituyen la misma prueba. Cambiar el nombre de un .jpg archivo a .png no modifica sus datos. Las cabeceras también pueden contener campos relativos al tamaño, la anchura de la imagen u otros detalles del archivo. Consulta el Guía sobre firmas de archivos y números mágicos para ver más ejemplos.
Buscar el inicio y el final de un archivo
Encontrar un encabezado es solo el primer paso. Una herramienta también debe determinar cuántos bytes tiene ese archivo.
Los tipos de archivo indican su fin de diferentes maneras:
- Algunos tienen un marcador de fin conocido.
- Algunos almacenan un archivo o una cantidad de datos.
- Algunos dividen los datos en fragmentos o registros.
- Otros necesitan un analizador sintáctico para leer la estructura del archivo.
Por lo tanto, la búsqueda de un encabezado y un pie de página no funcionará en todos los archivos. También puede aparecer un marcador de fin dentro de los datos normales. Algunos tipos de archivo no tienen un único marcador de fin.
Fragmentos PNG: por qué el primer resultado de IEND puede ser erróneo
En Especificación PNG del W3C indica que un archivo PNG comienza con una firma de ocho bytes. El formato PNG almacena el resto del archivo en bloques.
Cada bloque tiene cuatro campos:
Campo | Longitud | Propósito |
Longitud | 4 bytes | Indica el tamaño del campo de datos |
Tipo | 4 bytes | Asigna un nombre al fragmento |
Datos | Variable | Almacena los datos del fragmento |
CRC | 4 bytes | Comprueba el tipo y los datos |
Un fragmento completo utiliza 12 + longitud de los datos bytes. El campo «Longitud» no incluye ni a sí mismo, ni al campo «Tipo», ni al CRC.
Cada archivo PNG empieza con un IHDR bloque. Su campo de datos tiene siempre 13 bytes. El bloque completo tiene una longitud de 25 bytes.
Su firma utiliza desplazamientos 0x00–0x07. El primer fragmento empieza en 0x08. El siguiente fragmento comienza en 0x21:
0x08 + 25 = 0x21
Este cálculo indica dónde empieza el siguiente fragmento.
Consideremos un ejemplo de enseñanza basado en especificaciones: un archivo PNG válido de 136 bytes. Su tEXt «chunk» contiene el texto IEND como parte de un comentario.
Estructura | Inicio del fragmento | Longitud de los datos | Siguiente desplazamiento |
Firma de PNG |
| 8 bytes |
|
IHDR |
| 13 bytes |
|
tEXt |
| 56 bytes |
|
IDAT |
| 11 bytes |
|
IEND |
| 0 bytes |
|
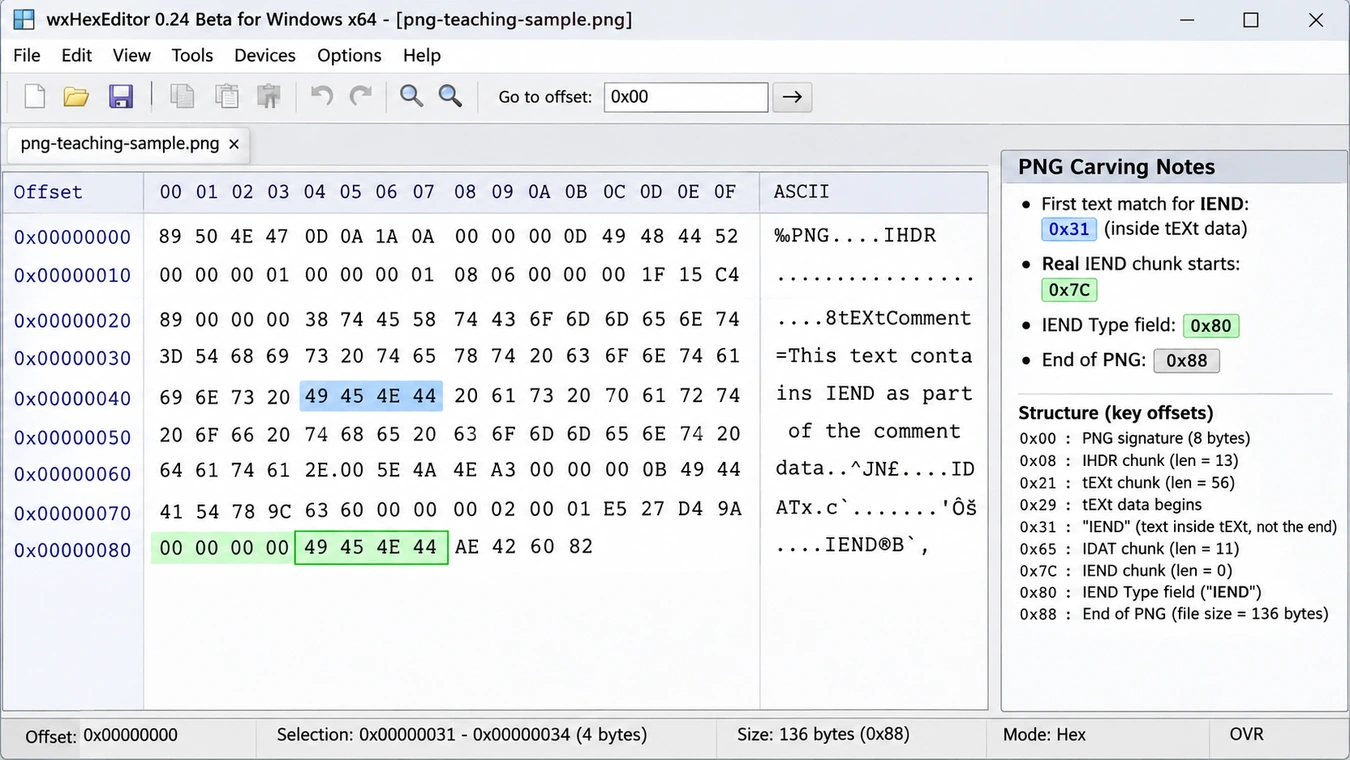
En tEXt los datos comienzan en 0x29. La primera coincidencia de texto para IEND está en 0x31. Se encuentra dentro de los datos de texto. No es el final del archivo PNG.
El verdadero IEND El fragmento comienza en 0x7C. El campo «Tipo» comienza en 0x80. Su campo «Data» no contiene bytes, por lo que el archivo PNG termina en 0x88.
Este ejemplo muestra por qué una búsqueda por bytes no es suficiente. Una búsqueda por bytes encuentra la primera coincidencia. Un analizador de archivos PNG lee cada campo «Length» y comprueba si IEND se encuentra en el campo «Tipo de bloque».
El formato PNG también incluye un CRC para cada fragmento. El CRC comprueba los campos «Tipo» y «Datos», pero no el campo «Longitud». Puede detectar algunos tipos de daños. Sin embargo, no puede demostrar que una imagen detectada sea idéntica a la original.
Copia y comprueba el archivo encontrado
Cuando una herramienta detecta el final probable, copia los datos. Pero un archivo copiado no siempre es un buen archivo.
Puede que tenga un encabezado válido, pero que le falten datos posteriores. También puede contener campos con un tamaño incorrecto, registros dañados o bytes procedentes de otros archivos.
Una herramienta puede comprobar el resultado de varias formas:
- Comprueba que estén presentes los encabezados y campos clave.
- Comprueba los valores de tamaño y los límites del archivo.
- Comprueba los CRC u otros controles de integridad cuando el tipo de archivo los incluya.
- Abrir o analizar el archivo encontrado.
- Compara su hash con una copia fiable, si existe.
Es posible que un archivo que se abre siga estando dañado. Algunas aplicaciones pueden mostrar solo una parte de una imagen o un documento dañado.
Técnicas de recuperación de archivos
Diferente técnicas de recuperación de archivos utilizar distintos niveles de detalle en los archivos. Una herramienta puede emplear más de un método en el mismo análisis.
Método | Cómo funciona | Límite principal |
Encabezado y pie de página | Busca patrones de inicio y fin | Puede aparecer un patrón dentro de otros datos |
Basado en el tamaño | Utiliza un tamaño conocido o un campo de tamaño | Es posible que se haya perdido la talla o que sea incorrecta. |
Basado en el diseño | Lee campos, fragmentos o registros | Se necesitan reglas para ese tipo de archivo |
Comprobaciones de contenido | Comprueba si los datos forman un archivo válido | Las comprobaciones varían según el tipo de archivo |
Búsqueda por fragmentos | Busca piezas que puedan ir juntas | Puede resultar difícil demostrar cuál es el orden correcto |
Encabezado, pie de página y tamaño
Estos métodos funcionan mejor cuando un tipo de archivo tiene datos de inicio y fin bien definidos. Una herramienta puede localizar una cabecera y buscar su marcador de fin. También puede leer un campo de tamaño y copiar ese número de bytes.
Sin embargo, un marcador de fin puede encontrarse dentro de los datos del archivo. Un campo de tamaño también puede referirse a una parte de un archivo más grande. Si una herramienta lee un valor incorrecto, puede que copie demasiados datos o muy pocos.
Comprobaciones de maquetación y contenido
Una herramienta basada en la estructura lee los componentes que contiene un archivo. Por ejemplo, puede leer los tamaños de los fragmentos de un archivo PNG o comprobar los registros de un archivo ZIP.
Las comprobaciones de contenido van un paso más allá. Verifican si las partes forman un archivo que tenga sentido. Estas comprobaciones pueden reducir las coincidencias erróneas. Sin embargo, no pueden recuperar los bytes que se han perdido.
Un archivo puede superar algunas comprobaciones y, aun así, diferir del archivo anterior. Estas comprobaciones refuerzan la confianza en un resultado, pero no demuestran que se trate del mismo archivo.
Buscar fragmentos de archivo
La búsqueda de fragmentos intenta volver a ordenar correctamente las partes del archivo fragmentado. Para ello, puede utilizar reglas de archivos, patrones de datos y otras pistas.
Un estudio de DFRWS sobre la división de archivos con comprobaciones de objetos analiza las formas de comprobar y unir partes de archivos.
Este trabajo es más complicado que un simple análisis de firmas. El resultado depende del tipo de archivo, de las partes que se conservan y de las pistas sobre su orden.
Recuperación de archivos mediante «file carving» frente a la recuperación basada en metadatos
La diferencia fundamental entre recuperación de archivos y la recuperación basada en metadatos consiste en los datos que utiliza cada método para localizar un archivo.
Comparación | Recuperación basada en metadatos | Recuperación de datos de archivos |
Pista principal | Registros del sistema de archivos y mapas de clústeres | Firmas de archivos y estructura de los datos |
Nombre anterior del archivo | Es posible que aún figure en los registros de archivos | Normalmente no se deduce solo a partir de los datos del archivo |
Ruta de la carpeta | Es posible que aún existan en los registros de la carpeta | Normalmente no se conserva |
Archivos fragmentados | Se pueden utilizar mapas de clústeres guardados | Se necesitan más pistas para unir las piezas |
Necesidad principal | Registros de archivos o mapas utilizables | Datos legibles y reglas de archivos conocidas |
Mejor ajuste | Los registros de archivos siguen siendo útiles para encontrar los datos | Los registros han desaparecido o no sirven de ayuda |
Cómo buscan los registros del sistema de archivos los datos
En el sistema de archivos NTFS, la Tabla Maestra de Archivos (MFT) contiene registros sobre los archivos. Un registro de archivo puede incluir datos que indican al sistema dónde se encuentra el contenido del archivo.
En el caso de los datos almacenados fuera del registro de archivo, los pares de asignación de NTFS enumeran las secuencias de datos. Pueden indicar qué clústeres contienen cada parte y el orden de dichas partes.
Microsoft explica estos registros en su Guía de la tabla de archivos maestros y Guía sobre el encabezado de los registros de atributos. Estas páginas tratan sobre la versión 3 de NTFS.
Otros sistemas de archivos utilizan otros mapas:
- FAT32 utiliza entradas FAT para vincular los clústeres que contienen un archivo.
- exFAT utiliza entradas de directorio para describir los datos de los archivos. Su
NoFatChainEste indicador indica si un archivo utiliza una secuencia de clústeres o una cadena FAT.
En Especificaciones de exFAT de Microsoft establece estas reglas. Si estos mapas siguen funcionando, una herramienta puede utilizarlos para localizar las partes fragmentadas en el orden correcto. Esto hace que la recuperación basada en metadatos tenga una ventaja frente a un análisis que solo busca firmas de archivos.
Sin embargo, el hecho de que los registros de los archivos estén en buen estado no demuestra que los datos sigan estando completos. El Prueba de la MFT de archivos eliminados en NTFS muestra por qué es necesario realizar comprobaciones específicas de los registros de los archivos, la ubicación de los datos y el contenido de los archivos. Para obtener más información sobre este método, consulta Recuperación de metadatos del sistema de archivos.
Explicación de la recuperación de datos sin procesar: por qué desaparecen los nombres de los archivos
Recuperación bruta A menudo se refiere a un análisis que lee datos sin utilizar los registros habituales de archivos y carpetas. En muchos casos, incluye un análisis de firmas de archivos y la recuperación de datos de archivos.
El término puede tener distintos significados según la herramienta. No se trata de un estándar del sistema de archivos. En este contexto, recuperación de datos mediante «carving» de archivos sin procesar significa buscar archivos en datos legibles sin utilizar los antiguos registros de carpetas.
Recuperación de archivos RAW sin los nombres originales de los archivos
Los sistemas de archivos almacenan los nombres de los archivos y las rutas de las carpetas en sus propios registros. No es necesario que esos nombres aparezcan en los datos del archivo.
Por lo tanto, es posible que una herramienta encuentre un archivo JPEG o PDF, pero no conozca su nombre anterior ni la carpeta en la que se encontraba. En ese caso, puede que le asigne un nuevo nombre al archivo encontrado.
PhotoRec indica que no recupera los nombres de los archivos antiguos ni las rutas de las carpetas. Localiza los archivos mediante sus firmas de datos. Consulta el Guía de PhotoRec.
Es posible que algunos datos sigan estando en el archivo. Un archivo JPEG puede contener datos EXIF. Un PDF puede contener un título o el nombre del autor. Estos datos no son lo mismo que el antiguo nombre del archivo o la ruta de la carpeta.
«Raw Recovery» no es un sistema de archivos RAW
La palabra RAW puede significar dos cosas:
- Recuperación en bruto: Un escaneo que lee datos sin utilizar los registros habituales de archivos y carpetas.
- Sistema de archivos RAW: Un volumen que Windows no puede leer como un sistema de archivos conocido.
Un volumen RAW no significa necesariamente que se hayan perdido todos los datos. Es posible que los registros del sistema de archivos estén dañados, sean difíciles de leer o pertenezcan a un sistema de archivos que Windows no admita.
Es posible que un escaneo sin procesar encuentre datos que se puedan leer. Sin embargo, no repara el volumen ni restaura su estructura de carpetas anterior.
El cifrado también es importante. Normalmente, es necesario desbloquear un volumen de BitLocker para que una herramienta pueda leer los archivos que contiene. PhotoRec explica esta necesidad en el caso de los volúmenes de BitLocker.
Por qué la fragmentación de los archivos limita la recuperación de datos
Un archivo se divide cuando sus datos se encuentran en más de una secuencia de clústeres. Una herramienta compatible con el sistema de archivos puede utilizar mapas de clústeres guardados para localizar cada parte. Es posible que un programa básico de recuperación de datos no disponga de dichos mapas.
Imagina un archivo que consta de tres partes:
A → B → C
Si las partes están una al lado de la otra, el orden de los datos también puede ser A → B → C. Una herramienta puede leer desde A hasta C si conoce el punto de inicio y el de fin correctos.
Ahora fíjate en un archivo dividido:
Orden de almacenamiento | Datos |
Bloque 1 | A |
Bloque 2 | X (datos de otro archivo) |
Bloque 3 | B |
Bloque 4 | C |
El archivo ocupa bloques consecutivos. Una lectura secuencial puede recopilar A, B y C en orden si se conocen el inicio y el límite.
Se trata únicamente de un modelo ilustrativo. A, B y C forman parte de un mismo archivo; X pertenece a datos no relacionados. Los bloques no representan páginas NAND físicas ni una imagen de disco real.
El archivo aún necesita A → B → C. Pero una lectura de A podría ser A → X → B. Se han mezclado datos de otro archivo.
Por lo tanto, un buen encabezado no demuestra que los bloques siguientes pertenezcan al mismo archivo. El Borrador del documento del NIST sobre la recuperación de archivos señala que los datos fragmentados son un problema clave para la recuperación de archivos.
¿Se pueden recuperar archivos fragmentados mediante el «file carving»?
A veces. Si los mapas del sistema de archivos siguen funcionando, una herramienta puede utilizarlos para localizar cada parte. La recuperación avanzada también puede recurrir a reglas de archivos y otras pistas.
Sin embargo, puede haber muchas piezas posibles. Es posible que el orden correcto no esté claro. Los datos comprimidos o encriptados pueden complicar aún más la tarea, ya que ocultan pistas en los datos.
No existe ningún método que garantice la reconstrucción de todos los archivos fragmentados a partir únicamente de sus datos. Véase Explicación sobre los archivos fragmentados Para obtener más información sobre los archivos divididos.
Limitaciones del «file carving» y condiciones de recuperación
El resultado depende de la cantidad de datos que una herramienta aún pueda leer y de su capacidad para localizar las partes del archivo.
Límite | Por qué es importante | Resultado posible |
Datos sobrescritos | Los nuevos datos sustituyen a los antiguos bytes | Es posible que se pierdan algunos datos o todos ellos |
TRIM SSD | Es posible que la unidad deje de mostrar los datos liberados | Es posible que ya no se puedan leer los datos antiguos |
Dividir archivos | Las piezas no están alineadas | Es posible que el archivo esté incompleto |
Sin un final claro | El archivo no tiene un punto final seguro | Es posible que la herramienta copie demasiado o muy poco. |
Coincidencias erróneas | Es posible que ese mismo patrón de bytes aparezca en otros datos | Es posible que se encuentre un archivo falso |
Cifrado | La herramienta no puede leer datos bloqueados | Es posible que no se muestren las firmas de los archivos |
Tipo de archivo desconocido | La herramienta no tiene reglas para ese tipo | Es posible que la herramienta no detecte el archivo |
Datos sobrescritos
Una herramienta solo puede copiar los bytes que aún es capaz de leer. No puede generar datos antiguos a partir de datos nuevos. Es posible que algunas partes se conserven tras una escritura parcial. Aun así, el archivo recuperado puede estar dañado o carecer de datos clave.
TRIM en los SSD y datos que no se pueden leer
En algunos sistemas, Windows puede enviar indicaciones TRIM o de desasignación cuando se libera espacio en el sistema de archivos. Estas indicaciones indican a la unidad que puede reutilizar esos bloques. Microsoft lo explica en su guía sobre Sugerencias sobre TRIM y Unmap.
TRIM no implica que todos los archivos eliminados desaparezcan de inmediato. El resultado depende de la unidad y de su configuración. Sin embargo, una vez que la unidad ha gestionado los bloques liberados, es posible que las operaciones de lectura normales ya no devuelvan los datos antiguos.
Por lo tanto, un escaneo no puede copiar datos que la unidad ya no muestra.
Datos bloqueados y tipos de archivo desconocidos
Los datos bloqueados suelen ocultar los patrones de bytes que una herramienta necesita para localizar un archivo. Es posible que la herramienta necesite que los datos se desbloqueen primero.
Es posible que una herramienta encuentre el inicio de un archivo, pero no consiga leer el resto. Esto puede ocurrir si no reconoce ese tipo de archivo o una versión más reciente del mismo.
Por lo tanto, que no haya resultados no siempre significa que no queden datos. Es posible que la herramienta no sepa cómo leer lo que hay.
Cómo comprobar los archivos grabados
Una coincidencia no significa que una herramienta haya encontrado un archivo completo. Comprueba cada resultado paso a paso.
Consulte | Qué muestra | Lo que no muestra |
Se ha encontrado la firma | Hay un patrón de bytes conocido | Ahí hay un archivo completo |
El formato del archivo parece correcto | Algunas reglas de archivos coinciden | Todos los datos antiguos siguen ahí |
Se abre el archivo | Una aplicación puede leer parte o la totalidad del contenido. | Es igual que el archivo antiguo |
El hash coincide con una copia antigua | Ambos archivos tienen el mismo número de bytes | El nombre o la carpeta anteriores |
Algunos tipos de archivo utilizan comprobaciones CRC. Estas pueden detectar algunos errores en los datos. Sin embargo, un CRC válido no demuestra que un archivo sea realmente el archivo original.
Si dispones de una copia fiable, compara los hash de los archivos. Si coinciden, significa que ambos archivos tienen los mismos bytes. Si no dispones de una copia, comprueba la estructura del archivo, su tamaño y su contenido, y verifica si una aplicación puede leerlo de principio a fin.
¿Cuándo conviene utilizar la recuperación de datos de archivos?
El «carving» puede resultar útil cuando los registros del sistema de archivos ya no indican dónde se encuentran los archivos, pero una herramienta aún puede leer algunos datos de los mismos.
Entre los casos más habituales se encuentran:
- Un sistema de archivos dañado en el que faltan registros de carpetas.
- Archivos eliminados cuyos registros ya no sirven de ayuda.
- Una unidad formateada que aún contiene datos antiguos.
- Una imagen de disco que hay que analizar para detectar tipos de archivo.
- Archivos que un análisis basado en metadatos no puede encontrar.
Si los registros de archivos siguen funcionando, la recuperación basada en metadatos puede ser la mejor opción inicial. Permite conservar los nombres anteriores, las rutas de las carpetas y las asignaciones de los archivos divididos.
Antes de intentar recuperar los datos, protege la unidad de origen:
- Deja de guardar datos nuevos en la unidad.
- No formatees, configures ni repares el dispositivo de origen antes de guardar los datos importantes.
- Si los datos son importantes, haz una imagen completa del disco antes de realizar más análisis.
- Escanea la imagen o utiliza una fuente de solo lectura siempre que puedas.
- Guarda los archivos encontrados en otra unidad.
Si la unidad hace ruido, se desconecta o presenta errores graves de lectura, deja de realizar escaneos repetidos. Seguir leyendo podría agravar el problema de una unidad defectuosa.
La recuperación de archivos, la reparación del sistema de archivos y la reparación de hardware no son lo mismo. El «carving» extrae datos que aún existen. No repara una unidad defectuosa ni reconstruye un sistema de archivos.
Conclusión
Tallado de limas localiza y copia archivos leyendo sus datos y su estructura. No necesita los antiguos registros del sistema de archivos. Su éxito depende de patrones de archivo conocidos, puntos de inicio y fin claros, datos legibles y pistas que indiquen el orden correcto de las partes del archivo.
Una coincidencia de firma es solo el primer paso. Las comprobaciones y pruebas de los archivos ayudan a determinar si el resultado está completo y es útil. Si los registros del sistema de archivos siguen funcionando, pueden contener detalles que un análisis de datos no puede recuperar, como nombres antiguos, rutas de carpetas y mapas de archivos fragmentados.
PREGUNTAS FRECUENTES
¿Qué es el «file carving» en la recuperación de datos?
¿Se pueden recuperar los nombres antiguos de los archivos mediante el «file carving»?
¿Se pueden recuperar archivos fragmentados mediante el «file carving»?
¿La recuperación «raw» es lo mismo que un sistema de archivos RAW?
¿Funciona la recuperación de archivos después de formatear un disco duro?
¿Se pueden recuperar con el «file carving» los datos que se han sobrescrito?
¿El TRIM del SSD impide la recuperación de archivos?
¿Es la recuperación basada en metadatos mejor que la extracción de archivos?

Vasilii es un especialista en recuperación de datos con unos 10 años de experiencia práctica en este campo. A lo largo de su carrera, ha resuelto con éxito miles de casos complejos relacionados con archivos borrados, unidades formateadas, particiones perdidas y sistemas de archivos RAW. Su experiencia abarca tanto métodos de recuperación manual con herramientas profesionales como editores hexadecimales como soluciones automatizadas avanzadas con software de recuperación. La misión de Vasilii es poner los conocimientos sobre recuperación de datos al alcance tanto de los profesionales informáticos como de los usuarios de a pie, ayudándoles a salvaguardar sus valiosos activos digitales.