
Voce di partizione GPT: campi “Structure”, “Array” e “GUID”
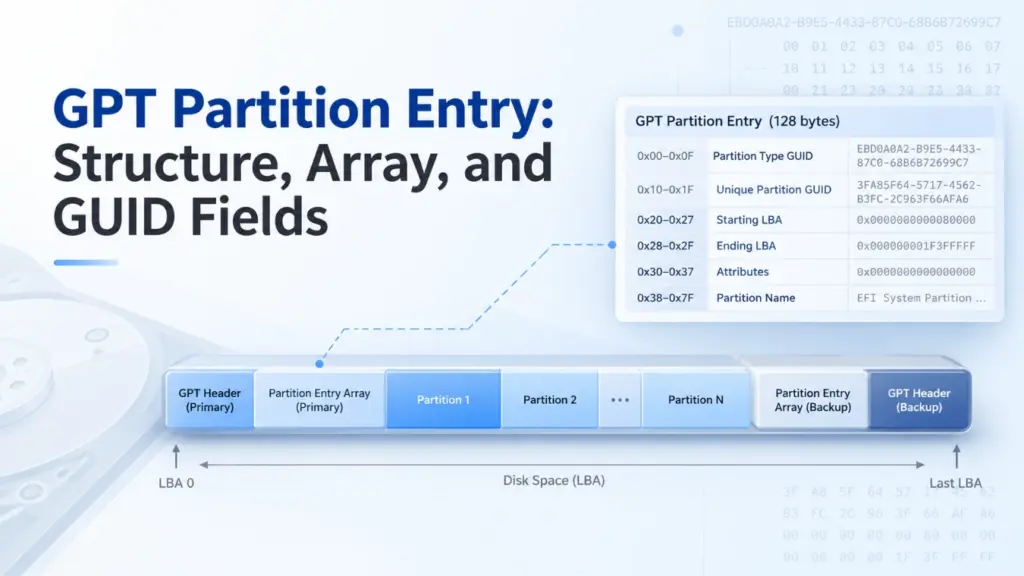
A Voce di partizione GPT è un record che descrive una partizione su un disco con tabella delle partizioni GUID (GPT). Identifica il tipo di partizione, il GUID univoco, gli indirizzi di blocco logico (LBA) di inizio e fine, gli attributi e il nome. Il solito Struttura delle voci delle partizioni GPT occupa 128 byte. Decodificando questi campi, è possibile individuare una partizione, calcolarne la dimensione e verificare che i relativi metadati siano corretti.
La presente guida segue la specifica UEFI 2.10 e utilizza Windows 10, Windows 11 e Windows Server come esempi pratici. Il formato GPT sottostante è applicabile anche ad altri sistemi operativi compatibili. Tutti gli esempi di byte riportati di seguito sono sintetici e non provengono da un disco reale.
Indice dei contenuti
Che cos’è una voce di partizione GPT?
A Voce di partizione GPT definisce l'identità e i confini di una partizione; non contiene i file della partizione. Per capire dove si colloca, occorre distinguere tre strutture:
Struttura | Cosa contiene |
Intestazione GPT | Posizione dell'array, numero e dimensione delle voci, intervallo LBA utilizzabile e checksum |
Matrice di voci di partizione GPT | Una sequenza di record di partizione, compresi gli slot non utilizzati |
Voce di partizione GPT | GUID, confini, attributi e nome di una partizione |
La voce indica al sistema operativo un’area di blocchi logici. Tale area può contenere un file system NTFS, FAT32, exFAT, un altro file system oppure dati privi di un file system convenzionale.
Per la struttura generale del disco, consultare il documento di Amagicsoft Panoramica sulla tabella delle partizioni GUID (GPT).
Struttura delle voci delle partizioni GPT: sei campi e i relativi offset
Specifiche UEFI 2.10, Sezione 5.3.3 definisce lo standard da 128 byte Struttura delle voci delle partizioni GPT:
Campo | Offset relativo | Lunghezza | Significato |
|
| 16 byte | Tipo di partizione previsto |
|
| 16 byte | Identificatore di questa specifica partizione |
|
| 8 byte | Primo blocco logico |
|
| 8 byte | Ultimo blocco logico, compreso |
|
| 8 byte | Maschera degli attributi a 64 bit |
|
| 72 byte | Nome memorizzato come unità di codice UTF-16LE |
Queste compensazioni iniziano all'inizio di una voce, non all'inizio del disco. Inoltre, 128 byte è la dimensione standard delle voci, non l'unica consentita. Con UEFI 2.10, Dimensione della voce di partizione deve essere uguale a 128 × 2^n, con un numero intero non negativo n. Per le voci più grandi, i byte oltre l'offset 0x7F sono riservati e devono essere pari a zero.
I due campi GUID
GUID del tipo di partizione indica al software a quale tipo di partizione si riferisce una voce. UniquePartitionGUID identifica quella specifica partizione. Ad esempio, due partizioni di dati di base possono condividere un GUID di tipo, ma non dovrebbero condividere un GUID di partizione univoco.
Nessuno dei due campi corrisponde all'identificatore del disco GPT. Il DiskGUID fa parte dell'intestazione GPT.
Confini della LBA e dimensione della partizione
A Voce di partizione GPT memorizza entrambi gli endpoint come interi a 64 bit senza segno, in formato little-endian. Poiché FineLBA è inclusivo, calcolare il numero di blocchi e la capacità come segue:
Numero di blocchi = LBA finale − LBA iniziale + 1
Dimensione in byte = Numero di blocchi × Dimensione logica del blocco
Se una partizione si estende dall'LBA 2048 all'LBA 4095, copre 2.048 blocchi. Con blocchi logici da 512 byte, la sua dimensione è pari a 1 MiB. Con blocchi logici da 4096 byte, la sua dimensione è pari a 8 MiB. Non dare mai per scontato che un LBA rappresenti sempre 512 byte.
Attributi e nome della partizione
Il Attributi Il campo contiene una maschera a 64 bit. L'UEFI definisce il bit 0 come "Partizione richiesta", il bit 1 come "Nessun protocollo I/O a blocchi" e il bit 2 come "Avviabile con BIOS legacy". Nella specifica UEFI 2.10, i bit da 3 a 47 sono riservati, mentre i bit da 48 a 63 sono specifici per il tipo di partizione.
Per i tipi di partizione Windows supportati, Documentazione di Microsoft sulle informazioni relative alle partizioni GPT definisce i flag dei bit superiori, tra cui "sola lettura" (bit 60), "copia shadow" (61), "nascosta" (62) e "senza lettera di unità predefinita" (63). Non applicare indiscriminatamente tali significati di Windows a ogni tipo di partizione.
Nome partizione contiene 36 unità di codice UTF-16 (72 byte). Un nome più breve utilizza la terminazione con carattere null. È importante sottolineare che questo nome GPT è distinto dall'etichetta del volume memorizzata all'interno di un file system. La lettura di un Voce di partizione GPT di per sé non determina l'etichetta che Windows visualizza per un volume montato.
Come funziona l'array delle voci di partizione GPT
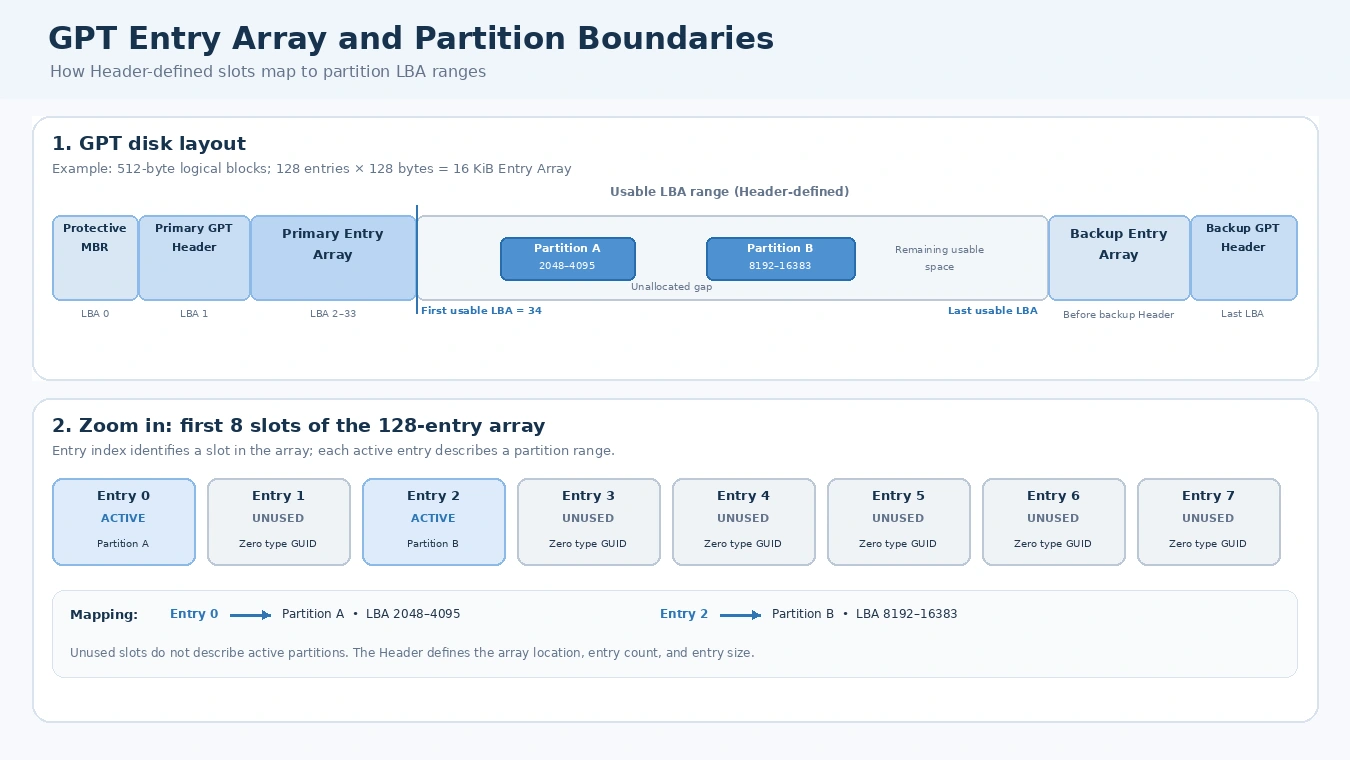
Il Matrice delle voci delle partizioni GPT contiene partizioni consecutive di uguale dimensione. La sua intestazione GPT specifica PartitionEntryLBA, Numero di voci di partizione, e Dimensione della voce di partizione. Pertanto, il software legge l'intestazione prima di poter individuare in modo affidabile un determinato record.
Array bytes = NumeroDiVociDellaPartizione × DimensioneDiUnaVoceDellaPartizione
Array blocchi logici = ceiling(Array byte ÷ Dimensione blocco logico)
L'UEFI 2.10 richiede almeno 16.384 byte di spazio per l'Entry Array. Una configurazione comune utilizza 128 slot da 128 byte ciascuno. Di conseguenza, occupa 32 blocchi su un disco a blocchi logici da 512 byte, oppure quattro blocchi su un disco da 4.096 byte. Tuttavia, 128 non è un limite universale per le partizioni. L’intestazione (Header) specifica il numero di voci.
Uno slot non utilizzato ha valore zero GUID del tipo di partizione; anche gli altri byte dovrebbero essere pari a zero in un array gestito correttamente. Quindi, 128 slot disponibili non non ovvero 128 partizioni attive.
Trova una voce specifica tramite l'indice
Per trovare l'articolo i, dove i se parte da zero, usa:
Offset assoluto in byte = (PartitionEntryLBA × Dimensione del blocco logico) + (i × Dimensione della voce di partizione)
Ad esempio, supponiamo che PartitionEntryLBA = 2, SizeOfPartitionEntry = 128, e i = 5.
Dimensione del blocco logico | Offset assoluto calcolato | Posizione sul disco |
512 byte |
| LBA 3, byte 128 |
4096 byte |
| LBA 2, byte 640 |
Si tratta di calcoli relativi a un esempio ipotetico, non di osservazioni effettuate su due dispositivi fisici. Si noti che lo stesso Voce di partizione GPT L'indice può trovarsi in diverse LBA quando cambia la dimensione del blocco logico del dispositivo.
Array primari e di backup
Un disco GPT convenzionale colloca l'intestazione primaria all'LBA 1 e l'intestazione di backup all'LBA finale. L'array delle voci primarie segue normalmente l'intestazione primaria; l'array di backup si trova prima dell'intestazione di backup. Le loro posizioni derivano dai rispettivi campi delle intestazioni, non da un intervallo di settori universale predefinito.
Il nostro Struttura dell'intestazione GPT e guida al CRC32 spiega in dettaglio questi campi dell'intestazione e la relazione tra i due array.
GUID del tipo di partizione GPT vs. GUID univoco della partizione
A GUID del tipo di partizione GPT descrive l'uso previsto della partizione. Un GUID univoco della partizione identifica una determinata partizione, mentre il GUID del disco identifica il disco GPT. Questi tre identificatori sono correlati ma non sono intercambiabili.
Tra i GUID di tipo comune relativi a Windows figurano:
Tipo di partizione | GUID di tipo |
Partizione di sistema EFI |
|
Riservato a Microsoft |
|
Dati di base su Microsoft |
|
Ripristino Microsoft |
|
Un GUID di tipo non identificare direttamente un file system. Ad esempio, una partizione Microsoft Basic Data potrebbe contenere NTFS, FAT32 o exFAT. Per riconoscerne il file system, il software deve esaminare i dati contenuti nella partizione.
Allo stesso modo, non tutti i dischi GPT dispongono di una partizione di sistema EFI. Un normale disco dati GPT potrebbe non averne bisogno.
Anche durante la copia dei dischi, la presenza di identificatori univoci duplicati può essere rilevante. Lo standard UEFI richiede che il software di copia compatibile con GPT generi nuovi GUID del disco e GUID univoci delle partizioni. Una clonazione “raw” potrebbe invece conservare gli identificatori originali, quindi non dare mai per scontato che una copia esatta contenga GUID appena generati.
Decodifica di una voce di partizione GPT da un valore esadecimale
Ecco l'esempio tecnico illustrato nell'articolo: un sintetico Voce di partizione GPT creata sulla base della struttura dei campi UEFI. È internamente coerente come singola voce, ma non costituisce un’immagine completa del disco GPT né un esperimento reale.
Campo | Esempio decodificato |
Tipo | Dati di base su Microsoft |
GUID di tipo |
|
GUID univoco |
|
LBA iniziale | 2048 |
LBA finale | 4095 |
Attributi |
|
Nome della partizione |
|
Voce della partizione “Dati di base sintetici”, non proveniente da un’acquisizione WinHex né da una lettura dal dispositivo. La voce è internamente coerente; non viene verificata né la struttura completa del disco né il CRC dell’intestazione GPT.
Passaggio 1: Decodificare il GUID del tipo
I primi 16 byte sono:
A2 A0 D0 EB E5 B9 33 44 87 C0 68 B6 B7 26 99 C7
La rappresentazione del GUID su disco utilizza l'ordine dei byte "little-endian" per le sue componenti di 4 byte, 2 byte e 2 byte. Pertanto:
A2 A0 D0 EBdiventaEBD0A0A2.E5 B9diventaB9E5.33 44diventa4433.- Gli altri otto byte generano
87C0-68B6B72699C7.
Il valore completo è il tipo di dati GUID di Microsoft Basic. Vedi la documentazione di Microsoft Specifiche di rappresentazione GUID for the underlying encoding.
Step 2: Decode the LBA fields
At relative offset 0x20, the bytes 00 08 00 00 00 00 00 00 represent decimal 2048 in little-endian order.
A 0x28, FF 0F 00 00 00 00 00 00 represents decimal 4095. Therefore, this Voce di partizione GPT describes 2,048 logical blocks, not 2,047.
If the device exposes 512-byte logical blocks, the starting byte offset equals 2048 × 512 = 1,048,576. If it exposes 4096-byte blocks, the corresponding offset is 8,388,608.
Step 3: Decode attributes and name
The example’s attribute bytes are all zero, so no attribute bits are set. At relative offset 0x38, the name starts with 44 00 41 00 54 00 41 00, which decodes to DATI in UTF-16LE.
A hex editor’s ASCII column may show D.A.T.A. because it treats the zero bytes as nonprintable characters. However, those periods are not part of the partition name.
Together, these steps let you move from raw bytes to a readable Voce di partizione GPT without treating GUID text, LBA values, and UTF-16LE text as if they shared one encoding.
How to Validate a GPT Partition Entry
A decoded Voce di partizione GPT is not necessarily a valid description of the disk. Check its fields against the GPT Header and other active entries.
Controllo | Cosa verificare | Perché è importante |
Active slot |
| All-zero type marks an unused slot |
LBA order |
| Rejects reversed or empty ranges |
Usable range | Both endpoints fall between | Keeps partitions out of reserved GPT space |
Overlap | Active entries describe disjoint ranges | Avoids conflicting partition descriptions |
Identifiers | Appropriate nonduplicate Unique Partition GUIDs | Avoids identity conflicts |
Reserved bits | Required reserved bits and bytes are zero | Checks compliance with the entry format |
These checks reveal metadata consistency, not the original cause of a failure. A Voce di partizione GPT is only one part of a broader disk-layout check. A boundary can be invalid even when its two 64-bit fields decode without error.
CRC32 checks cover the whole Entry Array
GPT does not store a CRC32 in each entry. Instead, the Header stores PartitionEntryArrayCRC32, calculated over exactly NumeroDiVociDellaPartizione × DimensioneDiUnaVoceDellaPartizione bytes. This range includes unused entry slots, but excludes any logical-block padding after the declared array length.
If software modifies a Voce di partizione GPT, it must update the Array CRC32 and then the corresponding Header CRC32. A matching checksum means that the bytes agree with the recorded checksum. It does non prove the partition boundaries, identifiers, or file system are correct.
For a complete integrity review, also compare the primary and backup GPT metadata. However, do not assume that a backup always preserves an older partition layout.
GPT validity is not file-system validity
A Voce di partizione GPT may accurately point to a partition whose NTFS or exFAT structures are damaged. Conversely, a deleted entry may leave much of the underlying data untouched. The partition table and the file system occupy different structural layers, so they require different checks.
Missing or Corrupted GPT Partition Entry: What Changes?
An unused slot, a deleted partition definition, and a damaged record are not identical:
- Unused: Its type GUID is zero, and a properly cleared slot has zero values in the remaining fields.
- Eliminato: A partitioning operation removes the definition from the active GPT layout. Depending on what else the operation does, the old file-system data may remain.
- Corrotto: A record contains inaccurate or conflicting information, such as an incorrect LBA boundary or GUID.
Windows may show the affected region as Unallocated or fail to mount a volume. Still, those symptoms alone cannot identify which Voce di partizione GPT field changed.
A valid backup array can sometimes help determine the intended layout. Yet a normal deletion may update both arrays, and an outdated backup may contain obsolete addresses. Therefore, restoring a record solely because it appears in a backup is unsafe.
If important data is at risk, avoid formatting, initializing, running destructive partition commands, or rewriting GPT metadata before preserving the source. If the drive repeatedly disconnects or reports serious read errors, stop unnecessary access.
GPT Partition Entry vs. MBR Partition Entry
Il Voce di partizione GPT provides more metadata than an MBR partition record, which occupies only 16 bytes.
Caratteristica | GPT | MBR |
Typical entry size | 128 bytes | 16 byte |
Tipo di partizione | 128-bit GUID | 8-bit type code |
Partition identifier | Unique Partition GUID | No equivalent per-entry GUID |
Range | 64-bit starting and ending LBAs | 32-bit starting LBA and sector count |
Nome | UTF-16LE field | No partition-name field |
Built-in metadata redundancy | Primary and backup structures | No built-in backup partition table |
MBR supports extended partitions to provide additional logical volumes. GPT instead uses an array whose slot count is declared in the Header. See the Tabella delle partizioni MBR for its record format.
GPT vs. MBR: See the Structural Difference
Compare the disk layouts and inspect the structure of each partition record.
Struttura del disco GPT
Modern structurePrimary and backup metadata; partition records live in arrays.
Common GPT layout. Exact array locations and sizes are defined by the headers.
MBR disk layout
Legacy structureThe first sector contains boot code and four partition-table entries.
Conceptual MBR layout. Extended partitions are optional.
Partition record fields: 128 bytes vs. 16 bytes
Record size at a common scale
At this shared scale, one GPT entry is eight times the size of one MBR entry. The colored field blocks in the two cards below are interactive.
GPT partition entry · 128 bytes (common)
Six defined fields describe type, identity, boundaries, attributes, and name.
MBR partition entry · 16 bytes
Four slots are stored in the MBR sector. Each slot uses a compact legacy record.
What changes when you use GPT instead of MBR?
| Caratteristica | GPT | MBR |
|---|---|---|
| Record size | 128 bytes is common; Header defines entry size and count. | 16 bytes per entry; four top-level slots in the MBR. |
| Tipo di partizione | 128-bit GUID | 8-bit type code |
| Rispondere a | 64-bit starting and ending LBA | 32-bit starting LBA and sector count |
| Partition count | Depends on the Entry Array size | Four primary-table slots; one may be an extended partition |
| Metadata redundancy | Primary and backup GPT metadata | No built-in backup partition table |
GPT is not simply a larger partition record. It uses a Header-defined array, GUID-based identifiers, 64-bit LBA boundaries, and backup metadata. MBR uses a compact 16-byte record and a four-slot table in the first sector.
Teaching example based on the GPT format defined by UEFI and the legacy MBR partition-record layout. The diagrams summarize structure; they do not read or modify a disk.
Conclusione
A Voce di partizione GPT connects a partition’s identity to its logical-block range. Its six fields explain what the partition is meant to be, where it resides, and which attributes apply. By combining the Struttura delle voci delle partizioni GPT, Header-defined array offsets, GUID decoding, and boundary checks, you can interpret GPT metadata without confusing it with the file system or assuming that a valid CRC32 proves the data is healthy.
FAQ
Ogni voce di partizione GPT ha una dimensione esatta di 128 byte?
128 × 2^n byte. L'intestazione Dimensione della voce di partizione Il campo indica al parser la dimensione effettiva. Pertanto, un parser che salta sempre in avanti esattamente di 128 byte potrebbe leggere in modo errato le voci di dimensioni maggiori.Un array di voci di partizione GPT può contenere più di 128 partizioni?
Il GUID del tipo di partizione GPT mi permette di capire se una partizione è NTFS?
Perché il GUID appare invertito in un editor esadecimale?
Il nome della partizione GPT corrisponde all’etichetta del volume?
È possibile che una voce di partizione GPT superi la verifica CRC32 ma sia comunque errata?
L'eliminazione di una voce di partizione GPT comporta la cancellazione dei file?

Vasilii è uno specialista del recupero dati con circa 10 anni di esperienza pratica nel settore. Nel corso della sua carriera, ha risolto con successo migliaia di casi complessi riguardanti file cancellati, unità formattate, partizioni perse e file system RAW. La sua esperienza copre sia i metodi di recupero manuale utilizzando strumenti professionali come gli editor esadecimali, sia le soluzioni automatiche avanzate con i software di recupero. La missione di Vasilii è quella di rendere accessibile la conoscenza del recupero dati affidabile sia ai professionisti IT che agli utenti di tutti i giorni, aiutandoli a salvaguardare i loro preziosi beni digitali.