
GPTヘッダー:構造、バックアップ、およびCRC32
A GPTヘッダー これは、ディスクのGUIDパーティションテーブル(GPT)を記述するメタデータ構造です。ディスクを識別し、パーティションエントリ配列の位置を特定し、使用可能なディスクの境界を定義し、メタデータの破損を検出するために使用されるチェックサムを格納します。GPTは、冗長性を確保するためにプライマリヘッダーとバックアップヘッダーを維持しています。 これらのバイト配置やCRC32フィールドを理解することで、パーティション情報がどのように検証されるのか、またヘッダーが破損しても必ずしもその下にあるファイルが失われるわけではない理由を説明しやすくなります。.
目次
GPTヘッダーとは何ですか?
GPTヘッダーは、UEFI仕様で定義されているディスクパーティション方式であるGUIDパーティションテーブル(GPT)の一部です。.
従来のマスター・ブート・レコード(MBR)方式とは異なり、GPTではパーティションのメタデータを2か所に保存しています。1つはディスクの先頭付近に、もう1つは末尾付近にあります。.
各GPTヘッダーには、関連するパーティションエントリ配列を特定し、解釈するために必要な情報が含まれており、具体的には以下のものが挙げられます:
- GPT形式を識別するための署名。.
- GPTヘッダーの改訂版とサイズ。.
- ヘッダー自体の位置と、代替ヘッダーの位置。.
- 最初および最後の有効な論理ブロックアドレス。.
- 一意のディスク識別子。.
- パーティションエントリ配列の位置とサイズ。.
- メタデータの整合性を確認するためのCRC32チェックサム。.
GPTヘッダーには、ファイル名、フォルダ構造、ファイルの内容は直接格納されていません。これらはパーティション内のファイルシステムに属しています。.
パーティショニング方式の概要については、以下を参照してください。 GPT(GUIDパーティションテーブル). 。公式の定義は、以下の UEFI仕様書、第5.3節.
GPTヘッダーはどこにあるのですか?
GPTは、プライマリメタデータとバックアップメタデータをディスクの両端に配置します。.
従来のGPTディスクの場合:
所在地 | 目次 |
LBA 0 | 保護用MBR |
LBA 1 | メインのGPTヘッダー |
LBAの追跡 | プライマリ・パーティション・エントリ・アレイ |
使用可能なLBA範囲 | パーティション用の空き容量 |
最終ブロック前のLBA | バックアップパーティションエントリ配列 |
最後のLBA | GPTヘッダーのバックアップ |
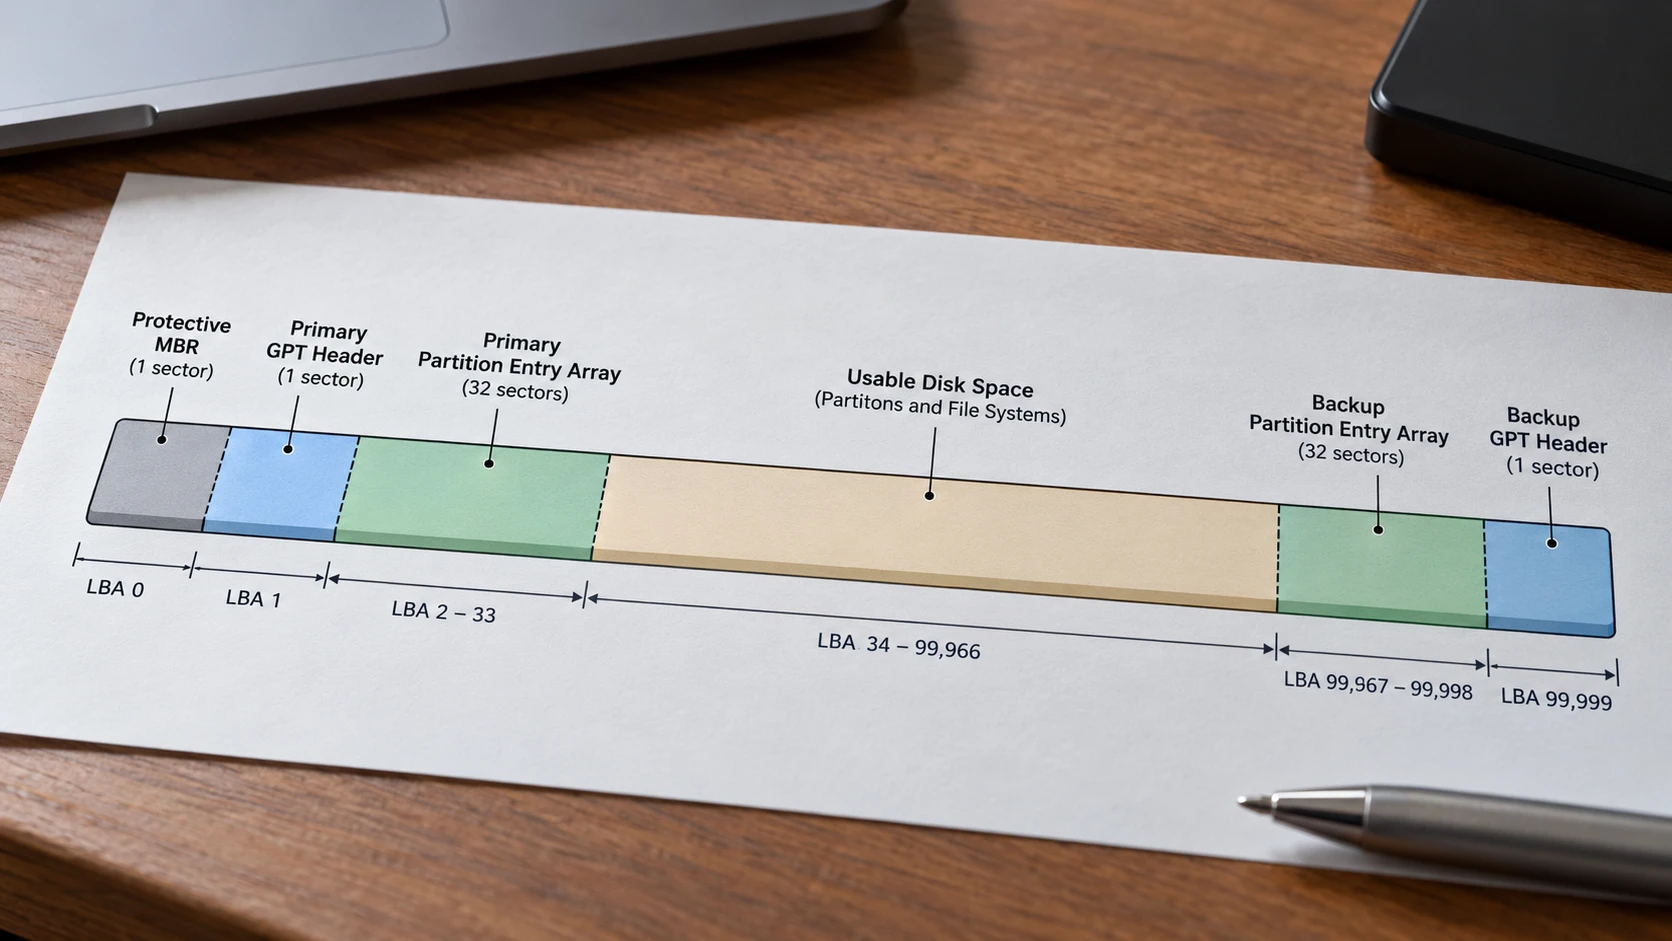
保護用MBRは、従来のMBR専用ツールがGPTディスクを「未割り当て」として扱うのを防ぐ役割を果たします。.
これはGPTヘッダーそのものとは異なります。従来のパーティションメタデータとの比較については、以下を参照してください。 MBRパーティションテーブル.
論理セクタとバイトアドレス
GPTは、構造体を識別するために、絶対バイトオフセットではなく、論理ブロックアドレス(LBA)を使用します。.
LBAをバイトオフセットに変換するには:
バイトオフセット = LBA × 論理ブロックサイズ
例えば、こうだ:
- 512バイトの論理ブロックを持つディスクでは、プライマリヘッダーはバイトオフセット
512(0x200). - 4,096バイトの論理ブロックを持つディスクでは、プライマリヘッダーはバイトオフセット
4096(0x1000).
ヘッダーは通常、論理ブロック内で92バイトを占めますが、このフォーマットでは、論理ブロックのサイズを上限として、それより大きなヘッダーも許可されています。.
92バイトのヘッダーを、512バイトのセクタと混同してはなりません。512バイトのヘッダーブロックの残りのバイトは予約済みであり、必ずゼロでなければなりません。.
GPTヘッダーの構造:フィールド、オフセット、およびサイズ
GPTヘッダー構造体は、 UEFI仕様書 2.10、表5.5.
以下のオフセットは、ディスクの先頭ではなく、GPTヘッダーの先頭からの相対位置を示しています。.
フィールド | オフセット(16進数) | サイズ | 目的 |
署名 |
| 8バイト | GPTヘッダーを識別します |
改訂 |
| 4バイト | GPT形式の改訂 |
ヘッダーサイズ |
| 4バイト | ヘッダーの長さ(バイト単位) |
ヘッダーCRC32 |
| 4バイト | ヘッダーのチェックサム |
予約 |
| 4バイト | 必ずゼロでなければならない |
MyLBA |
| 8バイト | このヘッダーの位置 |
代替LBA |
| 8バイト | もう一方のヘッダーの位置 |
FirstUsableLBA |
| 8バイト | 最初に使用可能なパーティションブロック |
最終使用可能LBA |
| 8バイト | 最後に使用可能なパーティションブロック |
ディスクGUID |
| 16バイト | 一意のディスク識別子 |
PartitionEntryLBA |
| 8バイト | 関連するエントリ配列の開始位置 |
パーティションエントリ数 |
| 4バイト | エントリー枠の数 |
パーティションエントリのサイズ |
| 4バイト | 各エントリのサイズ |
PartitionEntryArrayCRC32 |
| 4バイト | エントリ配列のチェックサム |
定義されたフィールドは、オフセットを占有します 0x00 ~を通じて 0x5B, 、合計92バイト。バイト数は 0x5C 論理ブロックの末尾までは予約されています。.
署名と改訂
有効なGPTヘッダーは、ASCII署名で始まります。 EFI パーツ.
その8バイトは以下の通りです:
45 46 49 20 50 41 52 54
標準のGPTリビジョン1.0は、リトルエンディアンのバイト列で次のように表されます:
00 00 01 00
これらは数値を表しています 0x00010000. GPTヘッダーのリビジョンは、UEFI仕様のバージョンとは異なります。.
一般的に使用されるヘッダーサイズは92バイトで、次のようにエンコードされます:
5C 00 00 00
ディスクGUIDとバイト順
DiskGUID フィールドは、オフセットから始まる 16 バイトを占めます。 0x38.
これはGPTディスクを識別するものです。これは、個々のパーティションエントリ内に格納されている一意のパーティションGUIDとは異なります。.
また、GUIDには、生の16進データを解釈する際に重要な点が1つあります。それは、最初の3つの構成要素はリトルエンディアン順で格納されているのに対し、最後の8バイトは表示順のまま保持されているということです。.
例えば、以下のGUIDを例として挙げると:
f0e1d2c3-b4a5-4c6d-8e9f-102030405060
次のように保存されます:
C3 D2 E1 F0 A5 B4 6D 4C 8E 9F 10 20 30 40 50 60
16バイトの生データをすべて左から右へ直接読み取ると、誤ったテキスト形式のGUIDが生成されてしまいます。.
パーティションエントリ配列のフィールド
パーティションエントリ配列は、3つのフィールドによって定義されます:
PartitionEntryLBA配列の開始位置を指定します。.パーティションエントリ数エントリ数を定義します。.パーティションエントリのサイズ各エントリのサイズを定義します。.
配列のバイト長は、次のように計算されます。
配列のサイズ = 要素数 × 要素サイズ
128個のエントリを含み、各エントリが128バイトである配列の場合:
128 × 128 = 16,384 バイト
512バイトの論理ブロックの場合:
16,384 ÷ 512 = 32 論理ブロック
これはパーティションエントリ配列の予約領域であり、実際のファイルデータが占める領域ではありません。.
現在の UEFI 仕様では、エントリのサイズを次のように定義しています。 128 × 2^n バイト、ここで n は非負の整数です。一般的なGPTディスクでは、128バイトのエントリが使用されます。.
プライマリおよびバックアップのGPTヘッダー:どのような変更があるか?
プライマリおよびバックアップのGPTヘッダーは、フィールド構造は同じですが、含まれるバイト内容は同一ではありません。.
それらの位置や、一部の内部ポインタが異なります。.
例として、次のようなGPTディスクを考えてみましょう:
- 100,000個の論理ブロック(番号付き)
0~を通じて99,999. - 論理ブロックサイズは512バイトです。.
- それぞれ128バイトのスロットを128個含むエントリ配列。.
- 両端に32ブロックのパーティションエントリ配列。.
レイアウトは以下の通りです:
構造 | プライマリGPT | GPTのバックアップ |
ヘッダーLBA |
|
|
MyLBA |
|
|
代替LBA |
|
|
PartitionEntryLBA |
|
|
エントリ配列の範囲 |
|
|
FirstUsableLBA |
|
|
最終使用可能LBA |
|
|
ヘッダーのサイズ | 92バイト | 92バイト |
これらの位置は、ディスクのサイズと、2つの32ブロックからなるパーティションエントリ配列から直接導き出されます。.
例えば、こうだ:
バックアップ・アレイの開始位置 = 最後のLBA − アレイのブロック数
99,999 − 32 = 99,967
最後に使用可能なブロックは、そのバックアップ配列の前に配置する必要があります:
99,967 − 1 = 99,966
したがって、両方のヘッダーは同じ使用可能なディスク範囲を表していますが、パーティションエントリ配列の物理的な位置はそれぞれ異なります。.
この仕組みにより、GPT対応のソフトウェアは、プライマリコピーが破損した場合にバックアップのメタデータを確認できるようになります。.
ただし、2つのコピーが存在しても、そのいずれかが有効である、あるいは最新であるとは限りません。.
解法例:16進数のバイト列からGPTヘッダーをデコードする
以下の例では、物理ディスクから取得したバイトデータではなく、意図的に作成されたGPTメタデータを使用しています。.
ここでは、前述の10万ブロックのディスクについて説明しています。.
この例には、値が設定されたパーティションは1つも含まれていません。128個すべてのパーティションエントリスロットはゼロで埋められており、これにより、完全に定義された入力から両方のエントリ配列のチェックサムを計算することが可能になります。.
手順 1:ヘッダーを特定する
プライマリヘッダーの先頭にある最初の16バイトは、次のとおりです:
45 46 49 20 50 41 52 54 00 00 01 00 5C 00 00 00
フィールドごとにシーケンスを分割します:
バイト範囲 | 16進数バイト | 解読された意味 |
|
|
|
|
| 改訂 |
|
| ヘッダーサイズ:92バイト |
署名、改訂、およびヘッダーのサイズは、想定される形式と一致しています。.
これにより、もっともらしいヘッダーが確立されますが、それだけではGPTが有効であることを証明するものではありません。.
ステップ 2:位置情報フィールドのデコード
メインヘッダーには以下の内容が含まれています:
フィールド | 保存されたバイト数 | 復号化された値 |
MyLBA |
|
|
代替LBA |
|
|
FirstUsableLBA |
|
|
最終使用可能LBA |
|
|
PartitionEntryLBA |
|
|
これらの値は、リトルエンディアンのバイト順を採用しています。.
たとえば、バイトは 9F 86 01 00 00 00 00 00 表す 0x000000000001869F, 、または小数 99,999.
バックアップヘッダーが逆向きになる MyLBA そして 代替LBA および変更点 PartitionEntryLBA への 99,967.
ステップ 3:ヘッダーのチェックサムを比較する
この特定の合成例では、前述のDiskGUIDと、0で埋められた16,384バイトのパーティションエントリ配列を使用した場合、算出される値は次のとおりです:
チェックサム | プライマリGPT | GPTのバックアップ |
ヘッダーCRC32 |
|
|
PartitionEntryArrayCRC32 |
|
|
ヘッダーのチェックサムが異なるのは、ヘッダーに含まれるロケーションフィールドが異なるためです。.
2つの配列には、どちらもゼロで埋められた同一のバイトが含まれているため、パーティションエントリ配列のチェックサムが一致しています。.
これらは計算上の例示値であり、普遍的なGPTチェックサム定数ではありません。ディスクのGUID、パーティションのレイアウト、またはメタデータが異なれば、結果も異なります。.
GPTヘッダーのCRC32検証の仕組み
GPTでは、パーティションのメタデータに変更がないかを確認するために、2つの独立したCRC32チェックサムを使用しています:
ヘッダーCRC32GPTヘッダーそのものを検証します。.PartitionEntryArrayCRC32関連付けられたパーティションエントリ配列を検証します。.
どちらも標準のCRC-32アルゴリズムを使用していますが、対象となるバイト範囲は異なります。.
HeaderCRC32:チェックサムの計算方法
について ヘッダーCRC32 このフィールドは、ヘッダーからの相対オフセットで4バイトを占める 0x10.
によると、 UEFI仕様, 、このフィールドを一時的にゼロに設定した状態でチェックサムを計算する必要があります。.
検証プロセスは、以下の5つのステップで構成されています:
- ヘッダーをお読みください。. ディスクイメージからGPTヘッダーのバイトを取得し、
ヘッダーサイズオフセット位置のフィールド0x0C. - 保存されたCRC32を記録してください。. オフセットにある4バイトを読み取る
0x10–0x13リトルエンディアンの32ビット値として。. - チェックサムフィールドをゼロに設定します。. 一時的なコピーの中で、これら4バイトを次のように置き換えてください。
00 00 00 00. - CRC32を計算する。. 正確に
ヘッダーサイズバイト。. - 結果を比較してください。. 計算された値が保存されている値と一致する場合、そのヘッダーはCRC32整合性チェックに合格します。.
標準の 92 バイトの GPT ヘッダーの場合、この計算ではオフセットが対象となります 0x00–0x5B, 、512バイトの論理セクタ全体ではなく。.
標準的なCRC-32計算ツール、あるいはPythonの zlib.crc32() 計算を行うことができます。このアルゴリズムでは、反射多項式を用いて 0xEDB88320, 初期レジスタ値は 0xFFFFFFFF, 、そして最終的なXOR演算として 0xFFFFFFFF.
例:GPTヘッダーのCRC32の検証
この記事の前半で用いた合成のGPTヘッダーについて考えてみましょう。.
項目 | 価値 |
ヘッダーサイズ |
|
保存されたヘッダーCRC32 |
|
保存されたバイト数 |
|
計算中のCRCフィールド |
|
算出されたCRC32 |
|
検証結果 | 試合 |
計算されたチェックサムは保存されている値と一致しており、このサンプルヘッダーがCRC32チェックに合格していることを示しています。.
対象となるバイトが1つでも変更され、保存されているチェックサムが更新されない場合、計算結果は通常、異なるものになります。.
重要 計算は、必ず一時コピーまたは読み取り専用の作業データに対して行ってください。元のディスク上のチェックサムバイトを上書きしないでください。.
0x76EF8C67 リトルエンディアン順で。選択 ゼロ 入力がどのように処理されるかを確認するには。.0xEDB88320 ・初期化 0xFFFFFFFF ・最終XOR 0xFFFFFFFF. 教育用サンプルであり、実際のディスクデータではありません。.PartitionEntryArrayCRC32: パーティションエントリの検証
2つ目のチェックサムは、, PartitionEntryArrayCRC32, はヘッダーからの相対オフセットに格納されています 0x58.
とは異なり ヘッダーCRC32, 、これはヘッダーではなく、パーティションエントリ配列を対象としています。.
その計算長は次のとおりです:
パーティションエントリ数 × パーティションエントリのサイズ
各要素が128バイトの要素を128個含む配列の場合:
128 × 128 = 16,384 バイト
このチェックサムを検証するには、16,384バイトの配列全体に対してCRC32を計算し、その結果をGPTヘッダーに格納されているチェックサムと比較してください。.
パーティションエントリ配列内では、チェックサムフィールドをゼロに設定する必要はありません。.
プライマリアレイとバックアップアレイは、配置場所が異なるため、個別に確認する必要があります。アレイの最後のエントリの後に残っている未使用のパディング領域は、計算から除外されます。.
なぜ両方のチェックサムが重要なのか
これら2つのチェックサムは、それぞれ異なる疑問に答えるものです:
- ヘッダーCRC32: ヘッダーのバイトは、ヘッダーに格納されているチェックサムと一致していますか?
- PartitionEntryArrayCRC32: パーティションエントリのバイトは、ヘッダーに格納されているチェックサムと一致していますか?
GPTヘッダーは、パーティションエントリ配列が破損しているにもかかわらず、自身のCRC32チェックに合格する場合があります。.
同様に、パーティションの境界が論理的に不正確であったり、メタデータが古くなっていたりする場合でも、両方のチェックサムが合格することがあります。.
CRC32は、メタデータの整合性を検証するものであり、ディスクの状態やファイルの復元可能性を検証するものではありません。. パーティションエントリに整合性があり、基盤となるファイルシステムに引き続きアクセスできるかどうかを確認するには、追加のチェックが必要です。.
GPTヘッダーが有効かどうかを確認する方法
UEFIでは、GPT対応ソフトウェアはヘッダーの署名、ヘッダーのCRC、, MyLBA, 、および関連するパーティションエントリ配列のCRC。プライマリGPTの場合は、代替ヘッダーも検証する必要があります。.
実地検査では、以下の追加の一貫性チェックを行う必要があります:
チェック | 想定される状態 | なぜそれが重要なのか |
署名 |
| 構造を特定する |
ヘッダーのサイズ | 少なくとも92バイト。論理ブロックサイズを超えないこと。 | チェックサムの範囲を定義します |
ヘッダーCRC32 | CRC32を再計算した結果 | ヘッダーバイトの変更を検出します |
MyLBA | 物理ヘッダーの位置と一致する | 誤って配置されたメタデータを検出します |
代替LBA | もう一方のヘッダーを指しています | 冗長なレイアウト検証に対応しています |
PartitionEntryLBA | ディスクの範囲内にある配列を指す | 無効な配列のアドレス指定を防止します |
PartitionEntryArrayCRC32 | 実際の配列のバイトと一致する | エントリ配列の破損を検出します |
使用可能なLBA範囲 | 順序付けられ、境界内にあり、メタデータ領域の外側にある | レイアウトの一貫性を確認する |
プライマリ/バックアップメタデータ | 必要な箇所では一貫性を保つ | 競合するコピーを検出します |
これらのチェックに合格しても、個々のファイルシステムやファイルが検証されるわけではありません。. パーティションエントリの境界についても、有効性や重複がないかを確認する必要があります。.
について UEFI GPT の検証要件 GPTメタデータが有効であるかどうかを判断するための規範的根拠を提供する。.
GPTヘッダーが破損するとどうなるのか?
その結果は、どのメタデータが引き続き利用可能かによって異なります。.
メインヘッダーが破損、バックアップは有効
プライマリGPTが無効な場合、GPT対応ソフトウェアは、最後の論理ブロックにあるヘッダーを検査し、それに関連付けられたパーティションエントリ配列の有効性を確認する必要があります。.
有効なバックアップがあれば、プラットフォームの復旧ポリシーに従い、プライマリコピーを再構築するために必要なメタデータを提供することができます。.
このような修復処理ではパーティションのメタデータが書き換えられるため、重要かつ保護されていないデータが含まれているディスクに対しては、安易に実行すべきではありません。.
バックアップヘッダーが破損していますが、プライマリは有効です
プライマリパーティションのレイアウトは、まだ読み取れる可能性があります。.
ただし、GPTの冗長性を維持するためには、バックアップを復元する必要があります。.
したがって、一見アクセス可能なディスクであっても、バックアップのメタデータが破損している可能性があります。.
両方のヘッダーが無効です
どちらのヘッダーも有効でない場合、UEFIの検証ルールに基づき、そのディスクには有効なGPTヘッダーが存在しないことになります。.
これは、必ずしもすべてのパーティションやファイルが物理的に消去されたことを意味するわけではありません。.
パーティションのメタデータ、ファイルシステムのメタデータ、およびファイルの内容は、ディスク上のそれぞれ異なる領域に格納されています。.
重要なファイルが関係する場合は、元のディスクを保存し、区別を付けてください 失われたパーティションのデータ復元 パーティションテーブルの書き換えから。.
ヘッダーは有効ですが、パーティション情報が正しくありません
構造的に有効なヘッダーだけでは、そのパーティションエントリが現在のディスクを正しく記述していることを立証するには不十分である。.
たとえば、レガシーなパーティション作成ソフトウェアによってディスクのレイアウトが変更された後、ディスクの末尾に古いGPTメタデータが残ってしまうことがあります。.
したがって、一見有効に見えるバックアップは、保護用MBR、現在のディスク容量、パーティションエントリ、およびその他の入手可能な証拠と併せて評価する必要があります。.
UEFIでは、ディスクがレガシーMBR形式に再フォーマットされた後、古いGPT構造に依存することに対して特に警告しています。.
GPTヘッダーを安全に検査する方法
詳細な分析を行うには、ディスクイメージまたは読み取り専用モードで動作する16進数ビューアを使用してください。.
- 正しい物理ディスクとその報告されている論理ブロックサイズを確認してください。.
- ディスクに重要なデータが含まれている場合は、メタデータを変更する前に、適切なイメージを作成してください。不安定なディスクや故障しつつあるディスクについては、適切な取得方法が必要です。.
- 書き込み操作を有効にせずに、画像を16進エディタで開きます。.
- LBA にあるプライマリヘッダーを特定してください
1, バイトオフセットに対応する論理ブロックサイズ × 1. - オフセット位置にある署名を確認してください
0x00そして、ヘッダーからの相対オフセットを用いて、その他のフィールドを解釈します。. - イメージまたはディスクの容量から最後のLBAを特定し、バックアップヘッダーを確認してください。.
- フィールドの値、ヘッダーのチェックサム、および関連するパーティションエントリ配列を比較します。.
Windowsの「ディスクの管理」とPowerShellの Get-Disk ディスクのパーティション形式を特定することはできますが、通常の概要表示では、バイト単位でのGPTヘッダーの完全な検証は行われません。.
DiskPart の初期化、フォーマット、実行は行わないでください クリーン 単にディスクがパーティションが無効である、あるいは存在しないと報告したからといって、そうとは限りません。同様に、CHKDSKはファイルシステムの修復ツールであり、一般的なGPTヘッダーの再構築手法ではありません。.
制限事項および重要なエッジケース
GPTヘッダーの解釈には、いくつかの条件が影響します。.
異なる論理ブロックサイズ。. 4Knディスクは、4,096バイトの論理ブロックを使用します。プライマリヘッダーはLBA 1, 、ただし、その絶対バイトオフセットは、512バイトの論理セクタを持つディスク上のものとは異なります。.
より大きなGPTヘッダー。. ヘッダーは、許容される論理ブロックサイズ内で92バイトを超える場合があります。CRC32では、実際に検証された ヘッダーサイズ, 、仮定された定数ではない。.
ディスクのサイズ変更またはクローン作成。. ディスクが拡張された場合、古いバックアップヘッダーが最終LBAに位置しなくなる可能性があります。修正を行う前に、現在のデバイスサイズに基づいてGPTメタデータを検証する必要があります。.
CRC32は暗号的な認証ではありません。. チェックサムが一致したからといって、メタデータが真正であることや、意図的な改ざんを受けていないことが証明されるわけではありません。.
物理メディアの問題。. 読み取りエラー、接続の不安定、またはコントローラの故障により、確実な検査が行えなくなる可能性があります。故障したハードウェアに対して繰り返し検査を試みると、復旧がさらに困難になる恐れがあります。.
こうした制限があるため、GPTの検証には、単一の署名やチェックサムの比較ではなく、いくつかの関連するチェックが必要となるのです。.
まとめ
について GPTヘッダー GUIDパーティションテーブルを解釈するために必要な位置、境界、識別子、および整合性情報を提供します。その構造は明示的なバイトオフセットによって定義されており、プライマリコピーとバックアップコピーがディスクの両端に冗長なメタデータを提供します。.
正確な分析には、単に場所を特定するだけでは不十分です EFI パーツ. ヘッダーのCRC32、パーティションエントリ配列のCRC32、LBAポインタ、使用可能な境界、およびプライマリ/バックアップの一貫性は、これらを総合的に評価する必要があります。.
これらの関係性を理解することで、有効なGPTメタデータを認識し、不整合を特定し、パーティションテーブルの破損とファイルデータの実際の損失とを区別することが可能になります。.
よくある質問
GPTヘッダーの署名とは何ですか?
EFI パーツ. 16進数では、これは 45 46 49 20 50 41 52 54. これはプライマリヘッダーとバックアップヘッダーの両方の先頭に現れます。このシーケンスが見つかったからといって、GPT全体が有効であると断定できるわけではありません。.GPTヘッダーはいくつのバイトですか?
ヘッダーサイズ このフィールドは、その実際の長さを定義します。この長さは、少なくとも92バイト以上で、かつ論理ブロックサイズ以下でなければなりません。論理ブロックの残りのバイトは予約されています。.プライマリおよびバックアップのGPTヘッダーはどこに保存されていますか?
1. バックアップヘッダーは、ディスクの最後の論理ブロックに格納されます。各ヘッダーの MyLBA 自身の位置を特定する一方で、 代替LBA もう一方のヘッダーを特定します。.プライマリGPTヘッダーとバックアップGPTヘッダーのCRC32値が異なるのはなぜですか?
MyLBA, 代替LBA, 、そして通常は PartitionEntryLBA. これらのバイトはヘッダーCRC32の対象となるため、たとえ両方のヘッダーが正確に同じディスクを表している場合でも、算出されるチェックサムは通常、異なることになります。.ディスクが破損している状態で、GPTヘッダーはCRC32検証を通過できるのでしょうか?
破損したGPTヘッダーは、バックアップから復元できますか?
GPTディスクのGUIDは、パーティションのGUIDと同じものですか?
ディスクGUID GPTヘッダー内のこのフィールドは、ディスクを識別します。個々のパーティションエントリには、パーティションタイプのGUIDや一意のパーティションGUIDなど、個別の識別子が含まれています。これらの値は役割が異なるため、混同しないようにしてください。.
バシリイは、この分野で約10年の実務経験を持つデータ復元のスペシャリストです。そのキャリアを通じて、彼は削除されたファイル、フォーマットされたドライブ、失われたパーティション、RAWファイルシステムを含む何千もの複雑なケースの解決に成功してきました。彼の専門知識は、16進エディタなどの専門ツールを使用した手動復元方法と、復元ソフトウェアを使用した高度な自動化ソリューションの両方をカバーしています。バシリの使命は、信頼できるデータ復元知識をITプロフェッショナルと一般ユーザーの双方が利用できるようにし、貴重なデジタル資産を保護できるようにすることです。.